
Bibliotecas predefinidas de DNBSEQ
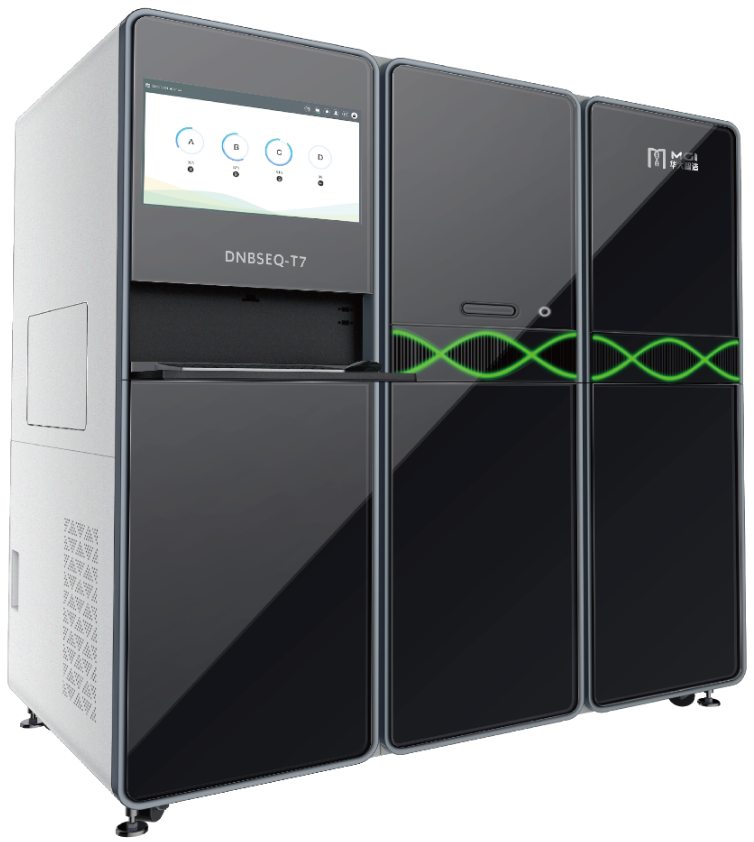
Características
●Plataforma:MGI-DNBSEQ-T7
●Modos de secuenciación:PE150
●Transferencia de bibliotecas de Illumina aMGI:Permite la secuenciación de grandes volúmenes de datos a bajo coste.
●Control de calidad de las bibliotecas antes de la secuenciación.
●Control de calidad y entrega de datos de secuenciación:Entrega del informe de control de calidad y los datos brutos en formato fastq después de la desmultiplexación y el filtrado de las lecturas Q30.
Ventajas
●Versatilidad de los servicios de secuenciación:El cliente puede optar por secuenciar por carril o por cantidad de datos.
●Alto nivel de datos:1500 Gb/carril
●Entrega del informe de control de calidad de secuenciación:con métricas de calidad, precisión de los datos y rendimiento general del proyecto de secuenciación.
●Proceso de secuenciación maduro:con un plazo de entrega corto.
●Control de calidad rigurosoImplementamos estrictos requisitos de control de calidad para garantizar la entrega de resultados de alta calidad de forma constante.
Requisitos de muestra
| Cantidad de datos (X) | Concentración (qPCR/nM) | Volumen | |
| Carril parcial
| X ≤ 10 Gb | ≥ 1 nM | ≥ 25 μl |
| 10 Gb < X ≤ 50 Gb | ≥ 2 nM | ≥ 25 μl | |
| 50 GB < X ≤ 100 GB | ≥ 3 nM | ≥ 25 μl | |
| X > 100 GB | ≥ 4 nM | ||
| Carril único | Por carril | ≥ 1,5 nM / grupo de la biblioteca | ≥ 25 μl / grupo de la biblioteca |
Además de la concentración y la cantidad total, también se requiere un patrón de picos adecuado.
Nota: La secuenciación por carriles de bibliotecas de baja diversidad requiere la adición de PhiX para garantizar una identificación de bases robusta.
Recomendamos enviar bibliotecas preagrupadas como muestras. Si necesita que BMKGENE realice la agrupación de bibliotecas, consulte los requisitos de biblioteca para la secuenciación parcial de carriles.
Tamaño de la biblioteca (Mapa de picos)
El pico principal debería estar entre 300 y 450 pb.
Las bibliotecas deben tener un único pico principal, sin contaminación por adaptadores y sin dímeros de cebadores.
Flujo de trabajo del servicio
Informe de control de calidad de la biblioteca
Antes de la secuenciación, se proporciona un informe sobre la calidad de la biblioteca, que evalúa la cantidad de material genético disponible y su fragmentación.
Informe de control de calidad de secuenciación
Tabla 1. Estadísticas sobre datos de secuenciación.
| ID de muestra | BMKID | Lecturas sin procesar | Datos brutos (pb) | Lecturas limpias (%) | Q20(%) | Q30 (%) | GC (%) |
| C_01 | BMK_01 | 22.870.120 | 6.861.036.000 | 96,48 | 99.14 | 94,85 | 36,67 |
| C_02 | BMK_02 | 14.717.867 | 4.415.360.100 | 96.00 | 98,95 | 93,89 | 37.08 |
Figura 1. Distribución de la calidad a lo largo de las lecturas en cada muestra.
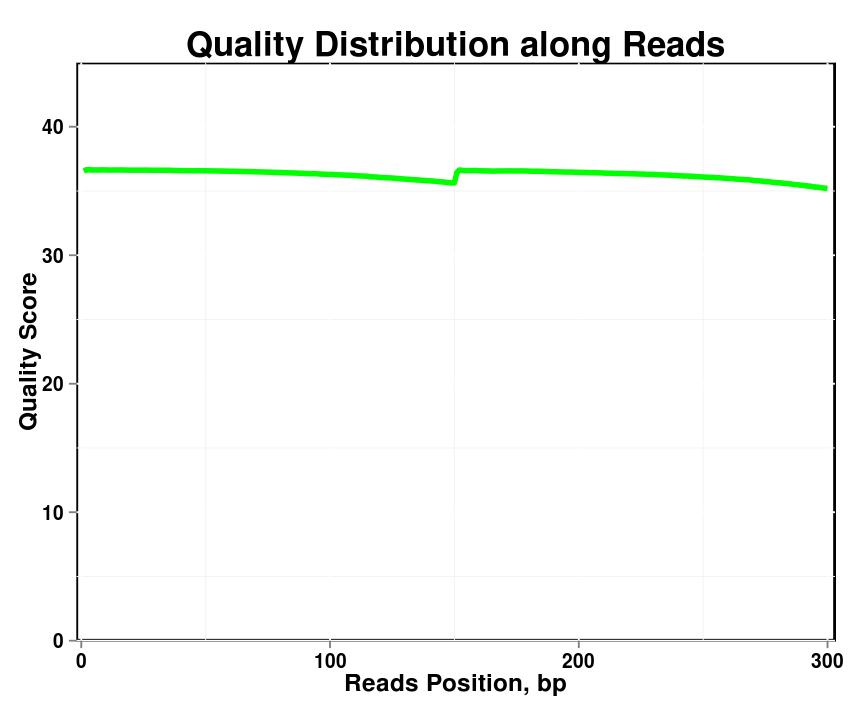
Figura 2. Distribución del contenido base
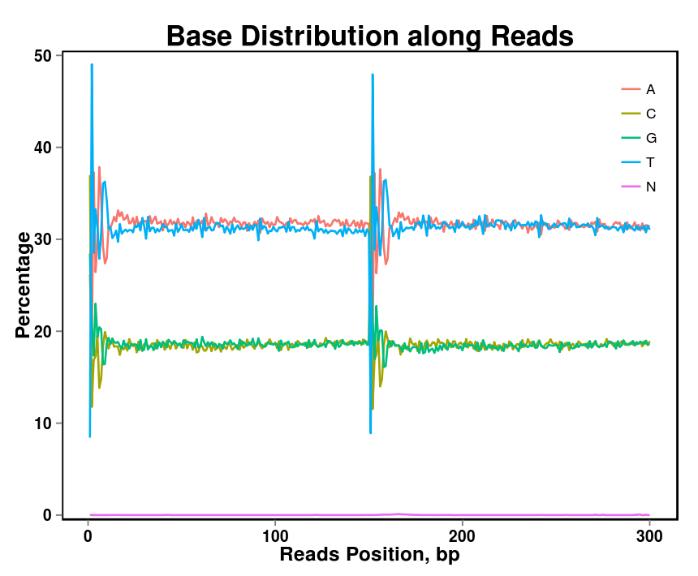
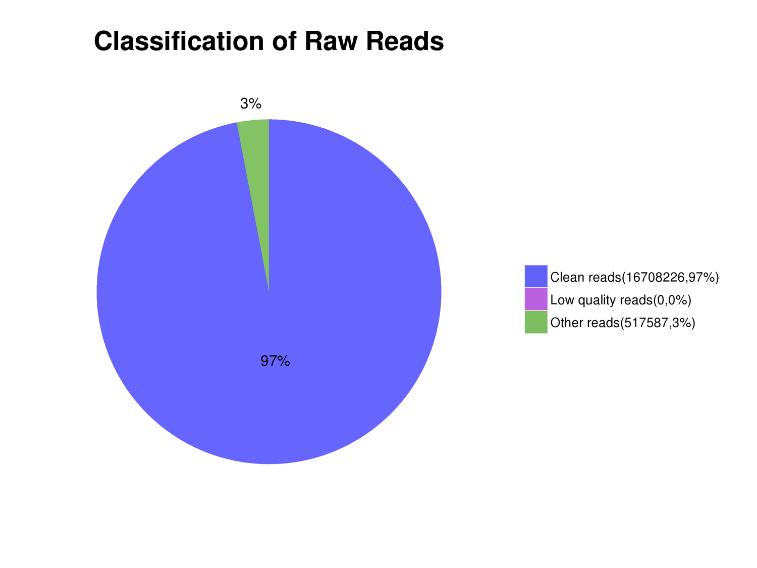
Figura 3. Distribución del contenido de lecturas en los datos de secuenciación.
Obtén un presupuesto
-

Secuenciación de ARNm/ARNnc largo/ARN circular exosómico - Illumina
-

Secuenciación metagenómica-TGS
-
Secuenciación de bisulfito del genoma completo (WGBS)
-
Secuenciación del genoma completo de plantas y animales
-
Secuenciación del metatranscriptoma
-
Secuenciación de secuencias largas no codificantes - Illumina


