DNBSEQ पूर्वनिर्मित पुस्तकालय
विशेषताएँ
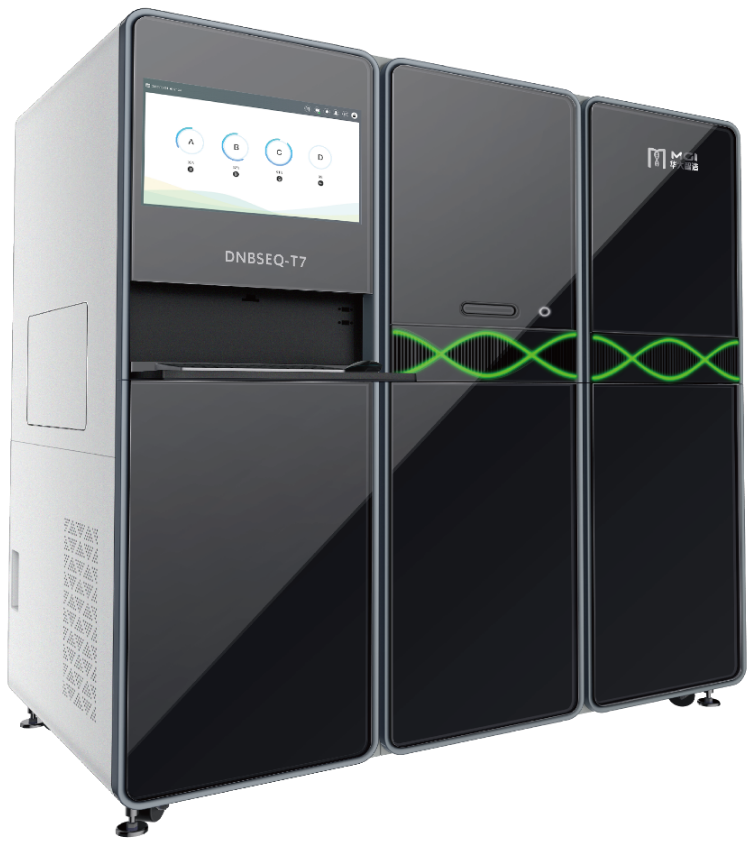
●प्लैटफ़ॉर्म:एमजीआई-डीएनबीएसईक्यू-टी7
●अनुक्रमण मोड:पीई150
●इलुमिना पुस्तकालयों का स्थानांतरणएमजीआई:कम लागत पर उच्च मात्रा में डेटा की सीक्वेंसिंग को सक्षम बनाना।
●सीक्वेंसिंग से पहले लाइब्रेरी की गुणवत्ता नियंत्रण।
●सीक्वेंसिंग डेटा की गुणवत्ता नियंत्रण और वितरण:Q30 रीड्स को डीमल्टीप्लेक्स और फ़िल्टर करने के बाद QC रिपोर्ट और रॉ डेटा को फास्टक्यू फॉर्मेट में डिलीवर करना।
लाभ
●सीक्वेंसिंग सेवाओं की बहुमुखी प्रतिभा:ग्राहक लेन या डेटा की मात्रा के आधार पर क्रमबद्ध करने का विकल्प चुन सकता है।
●उच्च डेटा आउटपुट:1500 जीबी/लेन
●सीक्वेंसिंग क्यूसी रिपोर्ट की डिलीवरी:गुणवत्ता मानकों, डेटा की सटीकता और अनुक्रमण परियोजना के समग्र प्रदर्शन के साथ।
●परिपक्व अनुक्रमण प्रक्रिया:कम समय में काम पूरा करना।
●कठोर गुणवत्ता नियंत्रणहम उच्च गुणवत्ता वाले परिणामों की निरंतर प्राप्ति सुनिश्चित करने के लिए सख्त गुणवत्ता नियंत्रण आवश्यकताओं को लागू करते हैं।
नमूना आवश्यकताएँ
| डेटा राशि (X) | सांद्रता (qPCR/nM) | आयतन | |
| आंशिक लेन
| X ≤ 10 Gb | ≥ 1nM | ≥ 25 μl |
| 10 जीबी < X ≤ 50 जीबी | ≥ 2 एनएम | ≥ 25 μl | |
| 50 जीबी < X ≤ 100 जीबी | ≥ 3 एनएम | ≥ 25 μl | |
| X > 100 जीबी | ≥ 4 एनएम | ||
| एकल लेन | प्रति लेन | ≥ 1.5 nM / लाइब्रेरी पूल | ≥ 25 μl / लाइब्रेरी पूल |
सांद्रता और कुल मात्रा के अलावा, एक उपयुक्त शिखर पैटर्न भी आवश्यक है।
नोट: कम विविधता वाली लाइब्रेरी की लेन सीक्वेंसिंग के लिए मजबूत बेस कॉलिंग सुनिश्चित करने के लिए PhiX स्पाइक-इन की आवश्यकता होती है।
हम प्री-पूल्ड लाइब्रेरी को सैंपल के रूप में सबमिट करने की सलाह देते हैं। यदि आपको BMKGENE द्वारा लाइब्रेरी पूलिंग की आवश्यकता है, तो कृपया आंशिक लेन सीक्वेंसिंग के लिए लाइब्रेरी संबंधी आवश्यकताओं को देखें।
पुस्तकालय का आकार (पीक मैप)
मुख्य शिखर 300-450 बीपी के बीच होना चाहिए।
लाइब्रेरी में एक ही मुख्य पीक होना चाहिए, कोई एडेप्टर संदूषण नहीं होना चाहिए और कोई प्राइमर डाइमर नहीं होना चाहिए।
सेवा कार्यप्रवाह
लाइब्रेरी क्यूसी रिपोर्ट
सीक्वेंसिंग से पहले लाइब्रेरी की गुणवत्ता पर एक रिपोर्ट प्रदान की जाती है, जिसमें लाइब्रेरी की मात्रा और विखंडन का आकलन किया जाता है।
अनुक्रमण क्यूसी रिपोर्ट
तालिका 1. अनुक्रमण डेटा पर सांख्यिकी।
| नमूना आईडी | बीएमकिड | रॉ रीड्स | कच्चा डेटा (बीपी) | साफ़ पठन (%) | Q20(%) | Q30(%) | जीसी(%) |
| सी_01 | बीएमके_01 | 22,870,120 | 6,861,036,000 | 96.48 | 99.14 | 94.85 | 36.67 |
| सी_02 | बीएमके_02 | 14,717,867 | 4,415,360,100 | 96.00 | 98.95 | 93.89 | 37.08 |
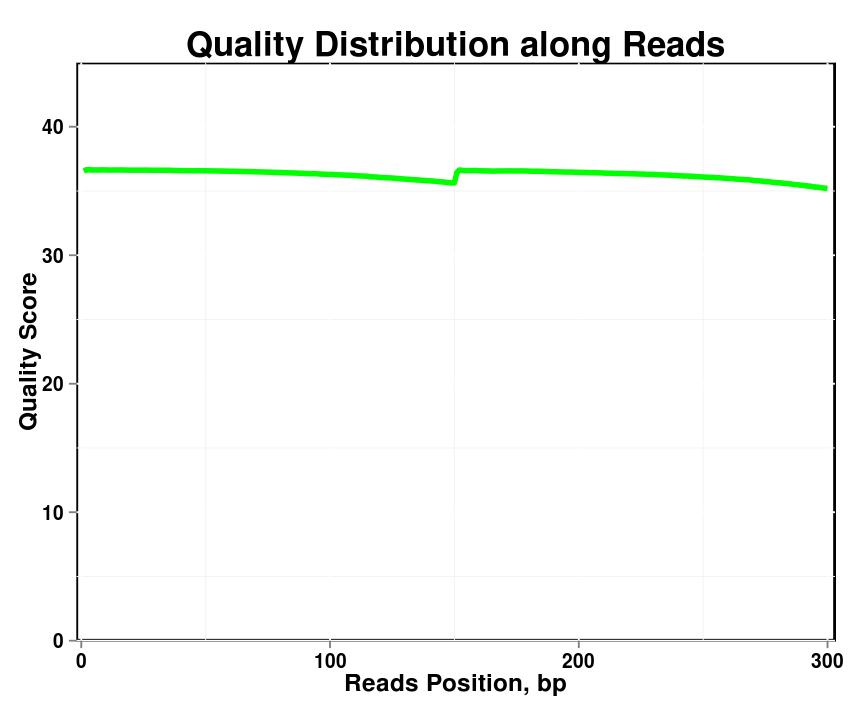
चित्र 1. प्रत्येक नमूने में रीड्स के साथ गुणवत्ता वितरण
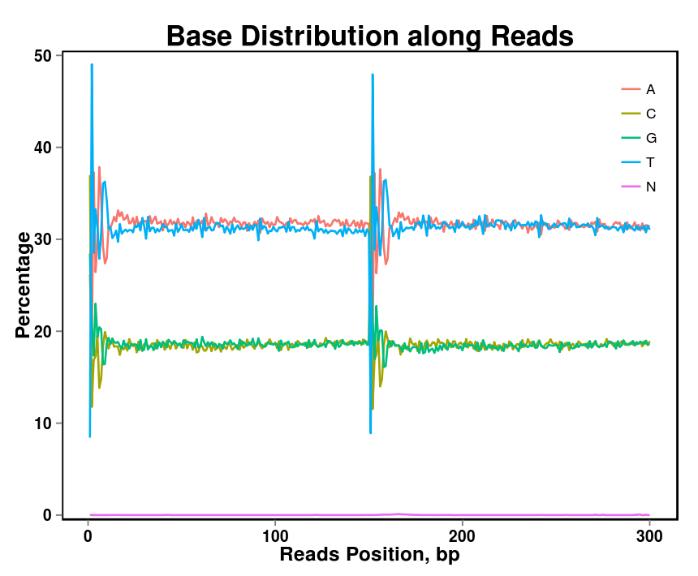
चित्र 2. आधार सामग्री वितरण
चित्र 3. अनुक्रमण डेटा में रीड सामग्री का वितरण