Biblioteki gotowe DNBSEQ
Cechy
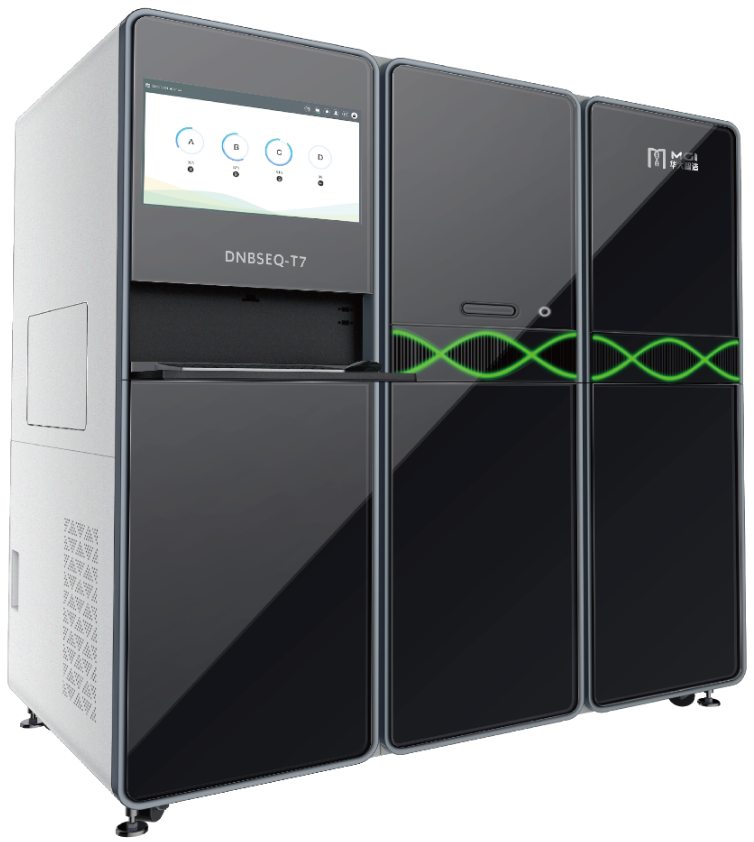
●Platforma:MGI-DNBSEQ-T7
●Tryby sekwencjonowania:PE150
●Przeniesienie bibliotek Illumina doMGI:umożliwiając sekwencjonowanie dużych ilości danych przy niskich kosztach.
●Kontrola jakości bibliotek przed sekwencjonowaniem.
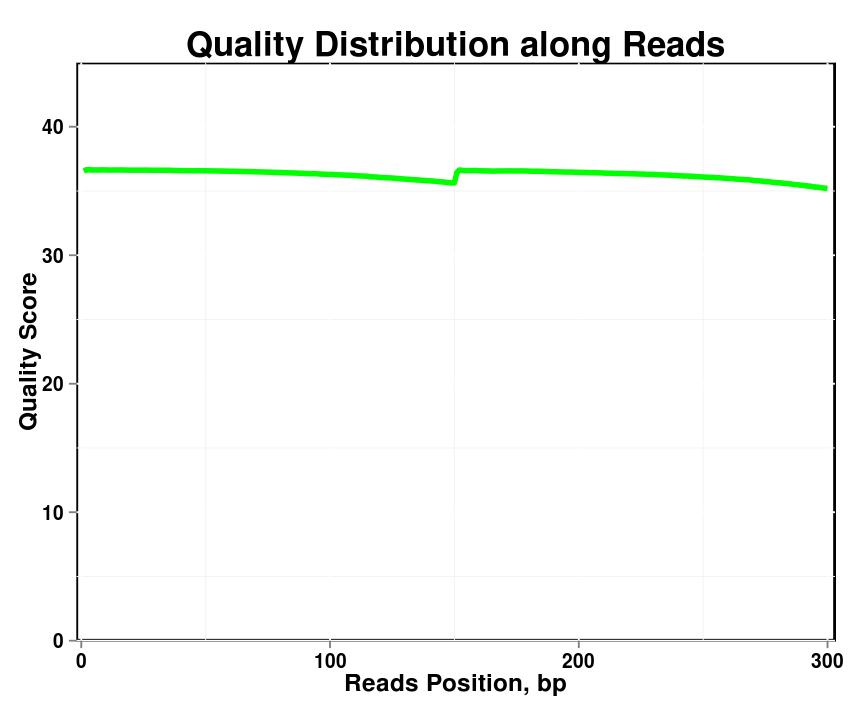
●Kontrola jakości i dostarczanie danych sekwencjonowania:dostarczanie raportu QC i surowych danych w formacie fastq po demultipleksowaniu i filtrowaniu odczytów Q30.
Zalety
●Wszechstronność usług sekwencjonowania:Klient może wybrać kolejność według pasa lub ilości danych.
●Wysoka wydajność danych:1500 Gb/pasmo
●Dostarczenie raportu kontroli jakości sekwencjonowania:z metrykami jakości, dokładnością danych i ogólną wydajnością projektu sekwencjonowania.
●Proces sekwencjonowania dojrzałego:z krótkim czasem realizacji.
●Rygorystyczna kontrola jakości:stosujemy surowe wymogi kontroli jakości, aby zagwarantować dostarczanie wyników o niezmiennie wysokiej jakości.
Przykładowe wymagania
| Ilość danych (X) | Stężenie (qPCR/nM) | Tom | |
| Częściowy pas ruchu
| X ≤ 10 Gb | ≥ 1nM | ≥ 25 μl |
| 10 Gb < X ≤ 50 Gb | ≥ 2 nM | ≥ 25 μl | |
| 50 GB < X ≤ 100 GB | ≥ 3 nM | ≥ 25 μl | |
| X > 100 GB | ≥ 4 nM | ||
| Pojedynczy pas ruchu | Na pas ruchu | ≥ 1,5 nM / Pula bibliotek | ≥ 25 μl / Pula bibliotek |
Oprócz stężenia i całkowitej ilości, wymagany jest także odpowiedni wzór szczytowy.
Uwaga: Sekwencjonowanie ścieżek w bibliotekach o niskiej różnorodności wymaga wprowadzenia impulsu PhiX w celu zapewnienia niezawodnego wywoływania zasad.
Zalecamy przesłanie wstępnie skompletowanych bibliotek jako próbek. Jeśli chcesz, aby BMKGENE przeprowadził skompletowanie bibliotek, zapoznaj się z wymaganiami dotyczącymi bibliotek w zakresie sekwencjonowania częściowego.
Rozmiar biblioteki (mapa szczytowa)
Główny pik powinien mieścić się w granicach 300–450 pb.
Biblioteki powinny mieć pojedynczy główny pik, nie powinny zawierać zanieczyszczeń adaptera ani dimerów starterów.
Przepływ pracy serwisowej
Raport kontroli jakości biblioteki
Przed sekwencjonowaniem sporządzany jest raport na temat jakości biblioteki, oceniający ilość biblioteki i stopień fragmentacji.
Raport kontroli jakości sekwencjonowania
Tabela 1. Statystyki danych sekwencjonowania.
| Identyfikator próbki | BMKID | Surowe odczyty | Surowe dane (bp) | Czyste odczyty (%) | Q20(%) | Q30(%) | GC(%) |
| C_01 | BMK_01 | 22 870 120 | 6 861 036 000 | 96,48 | 99,14 | 94,85 | 36,67 |
| C_02 | BMK_02 | 14 717 867 | 4 415 360 100 | 96,00 | 98,95 | 93,89 | 37.08 |
Rysunek 1. Dystrybucja jakości wzdłuż odczytów w każdej próbce
Rysunek 2. Dystrybucja zawartości bazowej
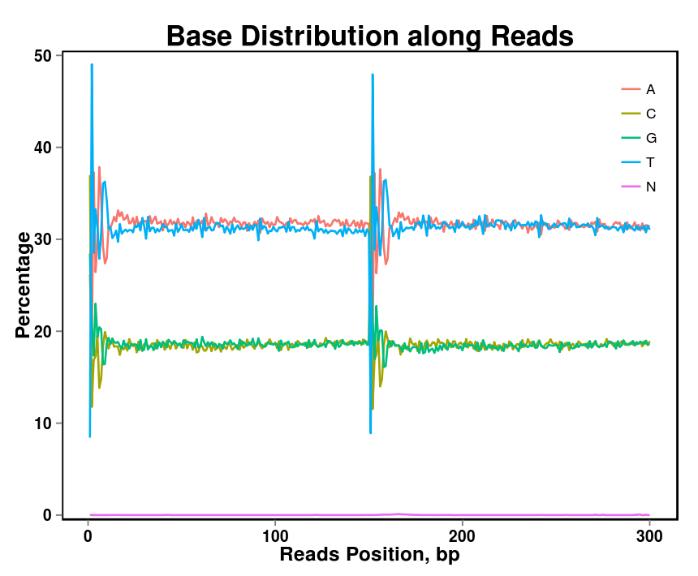
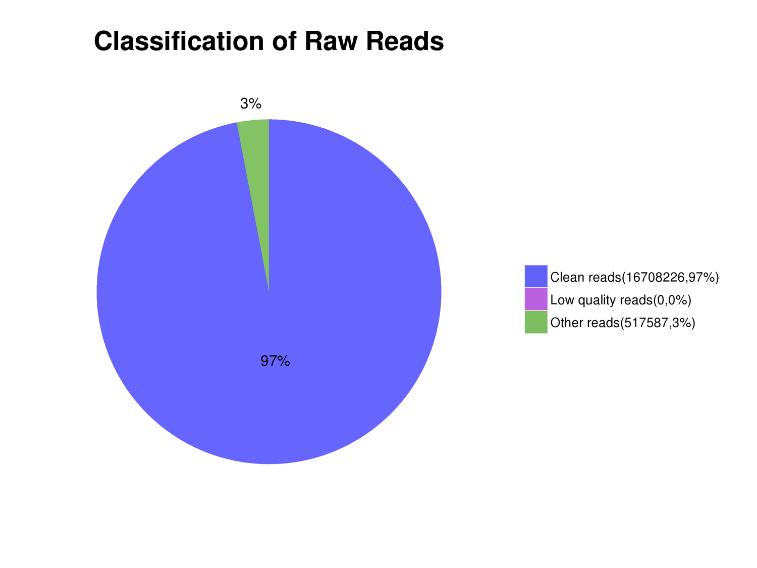
Rysunek 3. Dystrybucja odczytanej zawartości w danych sekwencjonowania