-

Secuenciación del genoma humano completo
La secuenciación del genoma humano completo (hWGS) es un método integral y potente para secuenciar el genoma completo de un individuo, con la capacidad de identificar mutaciones tanto en genes codificantes como en regiones no codificantes. Sus aplicaciones abarcan la investigación de enfermedades, la oncología, los estudios de evolución poblacional y mucho más, lo que la convierte en una piedra angular de la investigación genómica humana.
BMKGENE ofrece servicios de secuenciación del genoma humano completo, utilizando múltiples plataformas de secuenciación de última generación, junto con soluciones analíticas personalizadas diseñadas para la investigación de tumores y enfermedades genéticas.
-

Ensamblaje del genoma T2T | Secuenciación ultralarga
El ensamblaje genómico T2T (telómero a telómero) es el método de referencia para el ensamblaje de genomas de alta calidad, y se refiere a la reconstrucción del genoma a escala cromosómica, sin huecos, que abarca desde un telómero hasta el otro, y que supera los límites de fragmentación del ensamblaje genómico convencional.
Impulsada por la secuenciación de lectura ultralarga ONT e integrada con secuenciación profunda multiplataforma y pipelines bioinformáticos optimizados, la solución BMKGENE T2T Genome se centra en las regiones genómicas más difíciles de analizar: telómeros (complejos de nucleoproteínas especializados en los extremos de los cromosomas eucariotas), centrómeros de organismos superiores (matrices de repeticiones masivas en tándem) y otras regiones complejas de repeticiones y haplotipos heterocigotos, que durante mucho tiempo han sido irresolubles para la secuenciación estándar de lectura larga. A diferencia de las lecturas largas convencionales que no logran atravesar estas regiones y provocan el colapso de la secuencia o contigs quiméricos, las lecturas ultralargas ONT pueden abarcar huecos no ensamblables y regiones complejas. BMKGene se compromete a proporcionar genomas T2T de alta calidad, sin huecos o con huecos mínimos, para diversas especies.
La construcción de un genoma T2T desbloquea regiones genómicas complejas previamente inaccesibles, llena lagunas de investigación cruciales y proporciona datos fundamentales sólidos y de alta precisión para estudios en profundidad, incluyendo la evolución de las especies, la minería de genes funcionales, el mejoramiento molecular, la medicina de precisión y otras investigaciones científicas de vanguardia.
-

Proteómica
La proteómica se centra en las proteínas, ejecutoras de las actividades vitales que desempeñan un papel crucial en la regulación de la transcripción de los organismos. Analiza la composición, los niveles de expresión y los estados de modificación de todas las proteínas que cambian dinámicamente en tejidos o células, abordando el impacto significativo de la dinámica de la abundancia del proteoma en diversos procesos vitales. Se aplica ampliamente en medicina, agricultura y ganadería. La proteómica cualitativa utiliza la tecnología de identificación de proteínas HPLC-MS/MS para identificar muestras, incluidas tiras de gel, IP y muestras de CO-IP/Pull down. La proteómica cuantitativa logra la cuantificación e identificación precisas de todas las proteínas expresadas por un genoma o en un sistema mixto complejo. Las tecnologías actuales de proteómica cuantitativa se clasifican principalmente en enfoques con marcaje (TMT) y sin marcaje (Label Free, DIA, PRM). BMKGENE proporciona soluciones de proteómica multiplataforma y multitecnología.
-

Metabolómica
La metabolómica, una disciplina derivada de la genómica, se centra principalmente en sustancias de bajo peso molecular (menos de 1500 Da). Permite que los metabolitos reflejen con mayor precisión las respuestas de los organismos a estímulos externos y cambios fisiológicos/patológicos. Las variaciones genéticas también forman parte de su ámbito de investigación, lo que ofrece una perspectiva novedosa.
BMKGENE ofrece una gama completa de servicios de metabolómica, que incluyen metabolómica no dirigida, metabolómica dirigida y metabolómica dirigida. Mediante cromatografía líquida-espectrometría de masas (LC-MS) o cromatografía de gases-espectrometría de masas (GC-MS), se pueden detectar los cambios dinámicos en la mayoría de los metabolitos de molécula pequeña en los organismos antes y después de la estimulación externa. El núcleo de estos servicios reside en la identificación de metabolitos con diferencias significativas entre los grupos experimentales y de control, y en la exploración de su correlación con los cambios fisiológicos/patológicos y los mecanismos subyacentes.
-

Secuenciación de ARNm/ARNnc largo/ARN circular exosómico - Illumina
Los exosomas son pequeñas vesículas secretadas por las células, con un diámetro que suele oscilar entre 30 y 100 nanómetros. Estas vesículas contienen diversos ARN. Se cree que los exosomas desempeñan funciones cruciales en la comunicación intercelular, las respuestas inmunitarias y el desarrollo de enfermedades, y pueden diseminarse a otras partes del cuerpo a través de fluidos corporales como el plasma, la saliva y la orina. Transportan biomoléculas específicas para regular las funciones de las células receptoras, influyendo en sus estados fisiológicos. También se considera que los exosomas desempeñan un papel fundamental en el desarrollo de enfermedades, como el cáncer, las enfermedades neurodegenerativas y las afecciones inflamatorias. La investigación sobre los exosomas ofrece nuevas perspectivas y métodos para el diagnóstico, el tratamiento y la prevención de enfermedades.
-

Secuenciación de ARN pequeño exosómico - Illumina
Los exosomas son pequeñas vesículas secretadas por las células, con un diámetro que suele oscilar entre 30 y 100 nanómetros. Estas vesículas contienen diversos tipos de ARN. Entre los ARN presentes en los exosomas, el más común y estudiado es el microARN (miARN). El miARN es una clase de ARN pequeños no codificantes de aproximadamente 18 a 25 nucleótidos de longitud. Median el silenciamiento génico postranscripcional al unirse a la región 3' no traducida (3' UTR) de los ARNm diana, regulando así la expresión génica. Por ejemplo, los exosomas secretados por ciertas células tumorales contienen miARN específicos, como miR-126 y miR-92a. Estos miARN pueden influir en la expresión génica de las células receptoras y promover la angiogénesis tumoral (Tomohiro Umezu, et al., Oncogene, 2012).
-

BMKMANU S3000_Transcriptoma espacial
La transcriptómica espacial es una técnica que nos permite capturar y visualizar la expresión génica dentro de los tejidos. Esto puede ser crucial para comprender cómo interactúan las células.
Existen diferentes plataformas para este enfoque. En este sentido, BMKGene ha desarrollado el chip de transcriptoma espacial BMKManu 3000, una plataforma que mejora el rendimiento de la técnica, alcanzando una resolución subcelular y permitiendo una configuración de resolución multinivel.
Este chip contiene 4,2 millones de puntos mediante una tecnología patentada de micropocillos recubiertos con microesferas cargadas con sondas con códigos de barras espaciales. Con este método, tras la captura y amplificación, se obtiene una biblioteca de ADNc enriquecida con las muestras con códigos de barras, compatible con Illumina.
En cuanto a los datos, la combinación de códigos de barras espaciales e UMIs garantiza la precisión y especificidad de los datos generados. Al combinar todo lo anterior, BMKManu proporciona un entorno de datos extremadamente versátil.
-
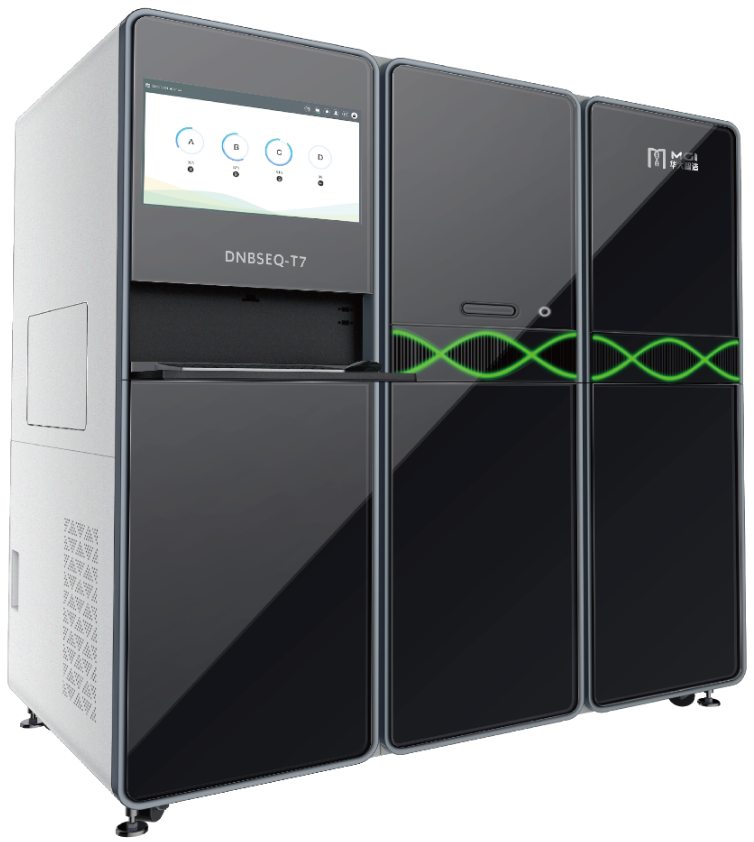
Bibliotecas predefinidas de DNBSEQ
DNBSEQ, desarrollada por MGI, es una innovadora tecnología de secuenciación de nueva generación (NGS) que ha logrado reducir aún más los costos de secuenciación y aumentar el rendimiento. La preparación de las bibliotecas DNBSEQ implica la fragmentación del ADN, la preparación de ADN monocatenario (ssDNA) y la amplificación por círculo rodante para obtener las nanobolas de ADN (DNB). Estas se cargan en una superficie sólida y posteriormente se secuencian mediante la síntesis combinatoria de sonda-anclaje (cPAS). La tecnología DNBSEQ combina las ventajas de una baja tasa de error de amplificación con el uso de patrones de error de alta densidad con nanobolas, lo que resulta en una secuenciación con mayor rendimiento y precisión.
Nuestro servicio de secuenciación de bibliotecas prefabricadas permite a los clientes preparar bibliotecas de secuenciación Illumina a partir de diversas fuentes (ARNm, genoma completo, amplicones, bibliotecas 10x, entre otras), que se convierten en bibliotecas MGI en nuestros laboratorios para ser secuenciadas en DNBSEQ-T7, lo que permite obtener grandes cantidades de datos a menor coste.
-
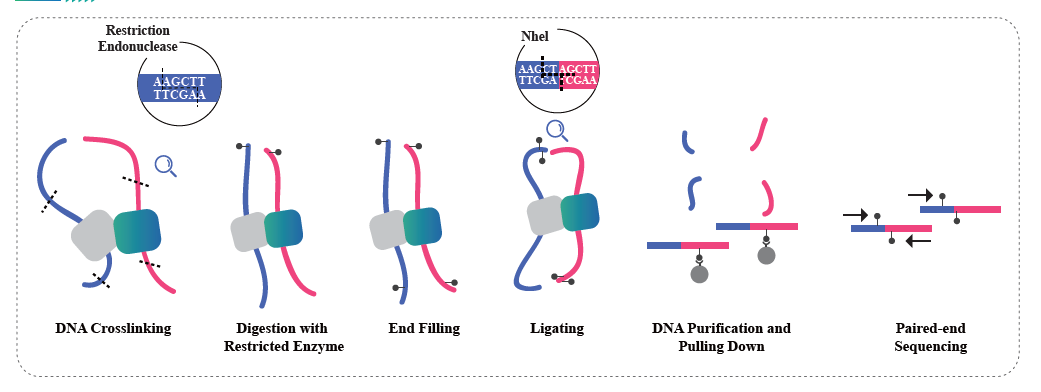
Interacción de la cromatina basada en Hi-C
Hi-C es un método diseñado para capturar la configuración genómica mediante la combinación de interacciones basadas en la proximidad y la secuenciación de alto rendimiento. El método se basa en la reticulación de la cromatina con formaldehído, seguida de digestión y religación, de manera que solo los fragmentos unidos covalentemente formen productos de ligación. Mediante la secuenciación de estos productos de ligación, es posible estudiar la organización tridimensional del genoma. Hi-C permite estudiar la distribución de las porciones del genoma que están poco compactadas (compartimentos A, eucromatina) y que tienen mayor probabilidad de ser transcripcionalmente activas, y las regiones que están más compactadas (compartimentos B, heterocromatina). Hi-C también se puede utilizar para identificar dominios asociados topológicamente (TAD), regiones del genoma que tienen estructuras plegadas y que probablemente tengan patrones de expresión similares, y para identificar bucles de cromatina, regiones de ADN ancladas entre sí por proteínas y que a menudo están enriquecidas en elementos reguladores. El servicio de secuenciación Hi-C de BMKGene permite a los investigadores explorar las dimensiones espaciales de la genómica, abriendo nuevas vías para comprender la regulación del genoma y sus implicaciones en la salud y la enfermedad.
-
Solución PacBio 2+3 de ARNm de longitud completa
Si bien la secuenciación de ARNm basada en NGS es una herramienta versátil para cuantificar la expresión génica, su dependencia de lecturas cortas limita su eficacia en análisis transcriptómicos complejos. Por otro lado, la secuenciación PacBio (Iso-Seq) emplea tecnología de lectura larga, lo que permite la secuenciación de transcritos de ARNm de longitud completa. Este enfoque facilita una exploración exhaustiva del empalme alternativo, las fusiones génicas y la poliadenilación, aunque no es la opción principal para la cuantificación de la expresión génica. La combinación 2+3 cierra la brecha entre Illumina y PacBio al utilizar lecturas PacBio HiFi para identificar el conjunto completo de isoformas de transcritos y la secuenciación NGS para cuantificar las isoformas idénticas.
Plataformas: PacBio Revio e Illumina NovaSeq
-
Análisis de asociación de todo el genoma
El objetivo de los estudios de asociación de genoma completo (GWAS, por sus siglas en inglés) es identificar variantes genéticas (genotipos) vinculadas a rasgos específicos (fenotipos). Mediante el análisis de marcadores genéticos en todo el genoma de un gran número de individuos, los GWAS extrapolan las asociaciones genotipo-fenotipo a través de análisis estadísticos a nivel poblacional. Esta metodología tiene amplias aplicaciones en la investigación de enfermedades humanas y en la exploración de genes funcionales relacionados con rasgos complejos en animales o plantas.
En BMKGENE, ofrecemos dos vías para realizar estudios de asociación del genoma completo (GWAS) en poblaciones numerosas: la secuenciación del genoma completo (WGS) o la secuenciación del genoma con representación reducida, mediante el método SLAF (Specific-Locus Amplified Fragment), desarrollado internamente. Si bien la WGS es adecuada para genomas más pequeños, SLAF se presenta como una alternativa rentable para estudiar poblaciones más grandes con genomas más largos, minimizando eficazmente los costos de secuenciación y garantizando una alta eficiencia en el descubrimiento de marcadores genéticos.
-

Secuenciación de ARN de núcleos individuales
El desarrollo de técnicas de captura de células individuales y construcción de bibliotecas personalizadas, junto con la secuenciación de alto rendimiento, ha revolucionado los estudios de expresión génica a nivel celular. Este avance permite un análisis más profundo y completo de poblaciones celulares complejas, superando las limitaciones asociadas con el promedio de la expresión génica en todas las células y preservando la verdadera heterogeneidad dentro de estas poblaciones. Si bien la secuenciación de ARN de célula individual (scRNA-seq) tiene ventajas innegables, presenta desafíos en ciertos tejidos donde la creación de una suspensión de células individuales resulta difícil y requiere muestras frescas. En BMKGene, abordamos este obstáculo ofreciendo secuenciación de ARN de núcleo único (snRNA-seq) mediante la tecnología de vanguardia 10X Genomics Chromium. Este enfoque amplía el espectro de muestras aptas para el análisis del transcriptoma a nivel de célula individual.
El aislamiento de núcleos se logra mediante el innovador chip Chromium de 10X Genomics, que cuenta con un sistema microfluídico de ocho canales con doble entrecruzamiento. Dentro de este sistema, microesferas de gel que incorporan códigos de barras, cebadores, enzimas y un solo núcleo se encapsulan en gotas de aceite de tamaño nanométrico, formando una emulsión de microesferas de gel (GEM). Tras la formación de la GEM, se produce la lisis celular y la liberación del código de barras dentro de cada GEM. Posteriormente, las moléculas de ARNm se someten a transcripción inversa para generar ADNc, que incorpora códigos de barras de 10X e identificadores moleculares únicos (UMI). Estos ADNc se someten luego a la construcción de una biblioteca de secuenciación estándar, lo que facilita una exploración robusta y completa de los perfiles de expresión génica a nivel de célula individual.
Plataforma: Plataforma 10× Genomics Chromium e Illumina NovaSeq
-
Secuenciación del genoma completo de plantas y animales
La secuenciación del genoma completo (WGS, por sus siglas en inglés) es una técnica que se utiliza para determinar la secuencia completa del ADN del genoma de un organismo en un solo momento.
Por lo general, el servicio se divide en dos grupos diferentes según la existencia de un genoma de referencia:
- De novosecuenciación del genoma completo.En esta situación, el genoma que se va a secuenciar no cuenta con un genoma de referencia disponible, por lo que el objetivo de esta secuenciación es generarlo (o mejorar uno existente). Esta técnica requiere el uso de datos de Illumina y secuenciación de lectura larga para optimizar el ensamblaje del genoma mediante la creación de solapamientos entre las lecturas.
- Resecuenciación.Se refiere a la secuenciación del genoma completo de diferentes individuos de especies con genomas de referencia conocidos. Sobre esta base, se pueden identificar con mayor precisión las diferencias genómicas entre individuos o poblaciones.